※この記事には広告・PRが含まれます。掲載内容は編集方針に基づき、読者の判断材料になるように作成しています。
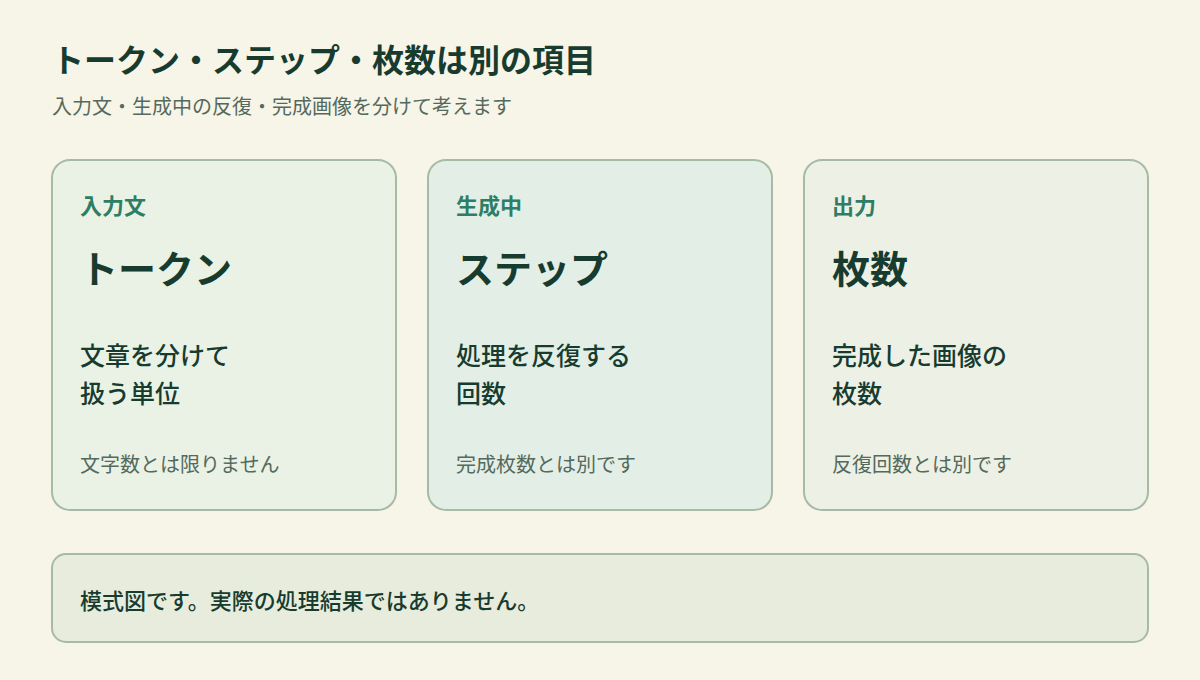
画像生成AIの基本用語であるトークンとステップは、文章を扱う単位と、生成処理の反復回数という違いがあります。トークンとは、モデルが文章を処理するために分けた単位です。ステップは拡散モデルでノイズを減らす処理の回数を指定するときなどに使われます。文章を長くする操作と、ステップ数を増やす操作は、同じ調整ではありません。
ここで扱うのは、画像生成に渡す文章のトークンと、DiffusersのStable Diffusionを例にした推論ステップです。画像そのものを表すトークンや、サービスの利用残高の説明とは分けます。設定項目の有無や入力上限は、使うモデルと機能で異なります。
画像生成AIの基本用語:トークンとステップは何を数える?
トークンは、文章を処理するための単位
入力した文章を、モデルで扱う単位に分ける処理をトークン化と呼びます。Hugging FaceのTransformers公式資料では、単語より小さい部分に分ける方式も説明されています。よく使う単語がそのまま一つの単位になる場合も、単語が複数の部分に分かれる場合もあります。Tokenization algorithmsで、分け方の例を確認できます。
そのため、日本語の文字数や英語の単語数を、そのままトークン数とはみなせません。どの分割方法を使うかによっても数え方が変わります。見た目が同じ長さの依頼文でも、同じ数のトークンになるとは限らないのです。
ステップは、生成中の反復処理に関わる値
DiffusersのStable Diffusionでは、num_inference_steps がノイズ除去のステップ数を指定する引数です。学習済みのモデルで出力を計算する処理を推論と呼びます。ここでいうステップはその画像生成の処理に関する項目で、完成画像を何枚作るかという指定とは別です。StableDiffusionPipelineの公式資料にも、ステップ数と画像枚数は異なる引数として掲載されています。
| 項目 | 何に関わるか | 混同しやすいもの |
|---|---|---|
| 入力文のトークン数 | モデルに渡す文章を分けた単位の数 | 文字数、単語数、利用残高 |
| 推論ステップ数 | 生成中のノイズ除去などの反復処理 | 依頼文の長さ、完成画像の枚数 |
| 生成する画像の枚数 | 出力として求める画像の数 | 一枚を作る途中のステップ数 |
👉 横にスクロールできます
たとえば「白い机の上に赤いマグカップ」と依頼したとします。この文章をどう分けて扱うかがトークン化に関わる話です。一方、入力条件に従って画像を作る途中の反復をどう指定するかが、ここで扱うステップ数の話です。表は役割の比較であり、この依頼文の実際のトークン数や生成結果を示したものではありません。
トークン数が気になるときは、文章の長さと優先順を確認する
文字数だけでは、入力の余裕は分からない
依頼文を入力できる長さと、その文章が何トークンになるかは別の情報です。利用画面に文字数の上限が示されているなら、その画面では文字数の条件を確認します。トークン数が表示される機能なら、対応するモデルの数え方と上限を確認してください。他のサービスで示された上限は、そのまま当てはめられません。
上限に達した文章をどう扱うかも、機能ごとの仕様です。入力できないのか、一部が処理の対象外になるのかを、見た目の文字数だけで判断しないようにします。生成ステップの値を変えることと、文章の入力条件を確かめることは別に進めます。
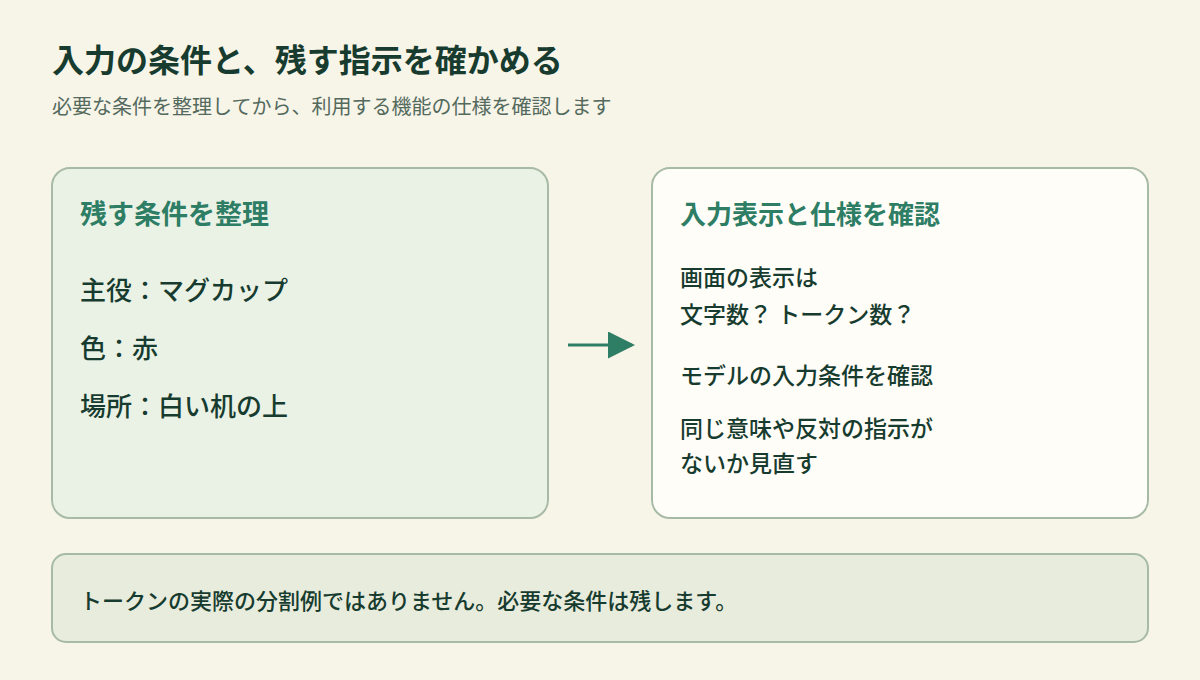
短くする場合は、必要な条件まで消さないことが先です。「赤いマグカップを白い机の上に置く」という依頼なら、主役、色、置く場所が残っているかを見ます。そのうえで、同じ意味の語を繰り返していないか、互いに反対の条件を並べていないかを確認します。これは依頼文を整理するための編集上の提案であり、短くすれば画質が上がるという検証結果ではありません。
ステップ数を比べる前に、モデルと生成方式をそろえる
同じ数値でも、処理の条件はそろわない
Diffusersの公式資料はステップ数を増やすと、一般に画質と推論の遅さとの兼ね合いが生じると説明しています。ただし、すべての画像生成機能に共通する最適な数値を示しているわけではありません。別のモデルや生成方式で使われている値を、理由なく移さないでください。
各段階でノイズをどのように減らすかを決める仕組みは、スケジューラーと呼ばれます。Schedulersの公式ガイドでは、まずモデルの既定の設定から始め、変更する場合は対応関係を確かめるよう案内されています。ステップ数だけを同じにしても、スケジューラーなどの条件が違えば、同じ処理を比べたことにはなりません。
調整できる項目が公開されていないサービスでは、自分で推論ステップを指定できると考えないようにします。画面の「品質」や「速度」という選択肢が、内部のどの値に対応するかも、説明がなければ断定できません。表示された機能の名前と、確認できた仕様の範囲で使い分けます。
一度に変える条件を一つにして、入力と出力を記録する
文章とステップ数を同時に変えない
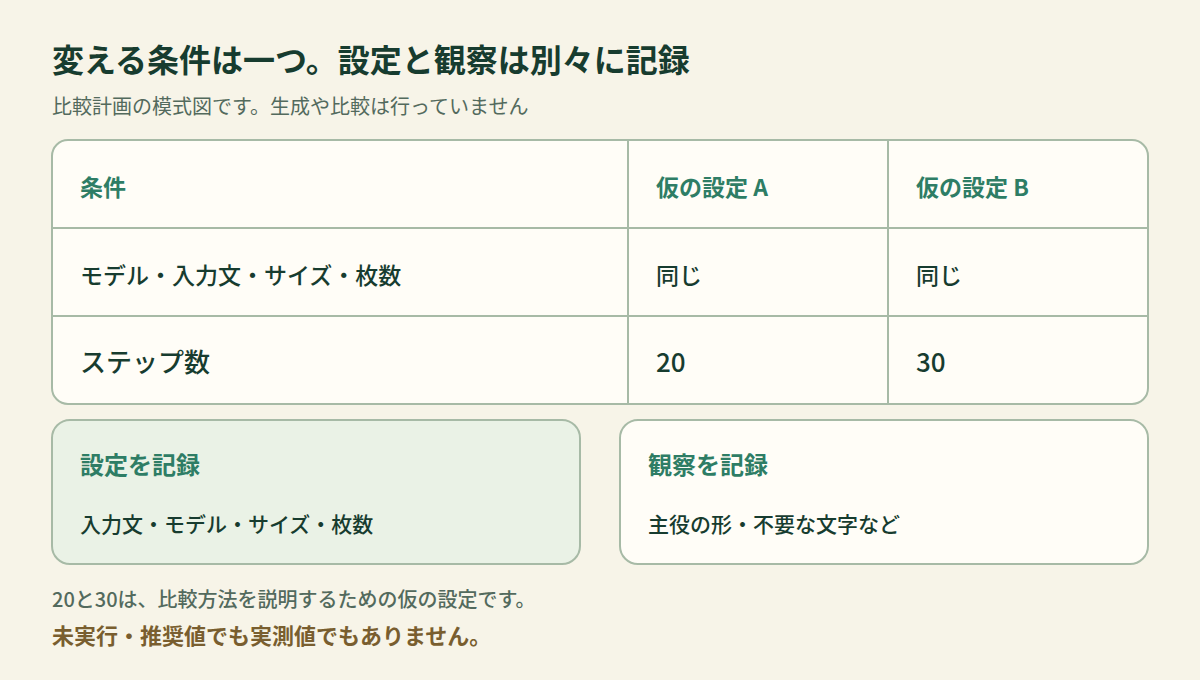
ステップ数の違いを確かめたいのに、同時に主役や画風も書き換えると、どの変更に伴って出力が変わったのかを分けにくくなります。まず使っているモデルと機能を記録し、文章、画像サイズ、生成枚数などの条件をそろえたうえで、変更する項目を決めます。
たとえば、同じ文章を使い、ステップ数だけを20から30へ変えて比べる、という計画は立てられます。この数値は比較方法を説明するための仮の設定で、推奨値でも実測値でもありません。実際に設定できる範囲は利用する機能の仕様に従い、サービスの利用上限や費用も確認します。設定できない項目を無理にそろえる必要はありません。
設定値と、出力の観察記録を分ける
記録欄にはモデル名、機能名、入力文、画像サイズ、ステップ数、生成枚数を残します。シードを指定できるなら、その値も記録対象です。シードは乱数の生成を管理するために使う値で、同じ値だけで環境をまたいだ完全な一致が保証されるわけではありません。Reproducibilityの公式ガイドでも、再現のための条件が説明されています。
観察した内容は設定欄とは別に書きます。「主役の形が依頼に合うか」「避けたい文字が残っているか」など、用途に関わる点を決めておくと、ステップ数の大きさだけで採否を決めずに済みます。何も変わらなかった場合や、違いを判断できなかった場合も、そのまま記録します。少数の出力から、すべてのモデルに当てはまる効果へ広げないでください。
文章側に必要な指示が足りないと分かったら、ステップの比較を続ける前に、依頼文の修正として区切ります。入力を直した後は新しい条件として扱い、前の結果と混ぜないようにします。次に何を変えたかを説明できる記録を残すことが、この比較方法の目的です。
よくある疑問:長い依頼文や多いステップが有利?
Q. 依頼文が長いほど、狙いどおりの画像になりますか?
A. 長さだけでは決まりません。必要な条件が含まれているか、矛盾がないか、入力条件に収まるかを確認します。トークン数は依頼の適切さを採点する点数ではありません。
Q. ステップ数を増やせば、不要なものは消えますか?
A. 消える保証はありません。ステップ数と、何を出したいか・避けたいかという入力内容は別の条件です。不要な特徴の指定方法や、そのモデルで対応する機能を確認します。
Q. 別のモデルでも、同じステップ数を使えば比較できますか?
A. 同じ数値というだけでは、条件をそろえた比較にはなりません。モデルやスケジューラー、設定できる項目の違いを確認し、何を比べているかを分けて記録してください。
Q. 画面に「トークン」と表示されたら、すべて入力文の量ですか?
A. そうとは限りません。この記事は入力文を分ける単位を扱っています。利用残高や課金の単位などは、表示元の説明で確かめ、入力文のトークン数と混同しないようにします。
参考資料と関連記事
一次資料の確認日:2026年11月6日。生成や速度の比較試験は実施していません。
- Hugging Face Transformers:Tokenization algorithms
- Hugging Face Diffusers:StableDiffusionPipeline
- Hugging Face Diffusers:Schedulers
- Hugging Face Diffusers:Reproducibility
依頼する画像の条件を整理したいときは、画像生成を頼む前の依頼書の作り方へ。不要な要素を避ける指定については、画像生成AIのネガティブプロンプトの役割と使い方を参照してください。
あわせて読みたい